
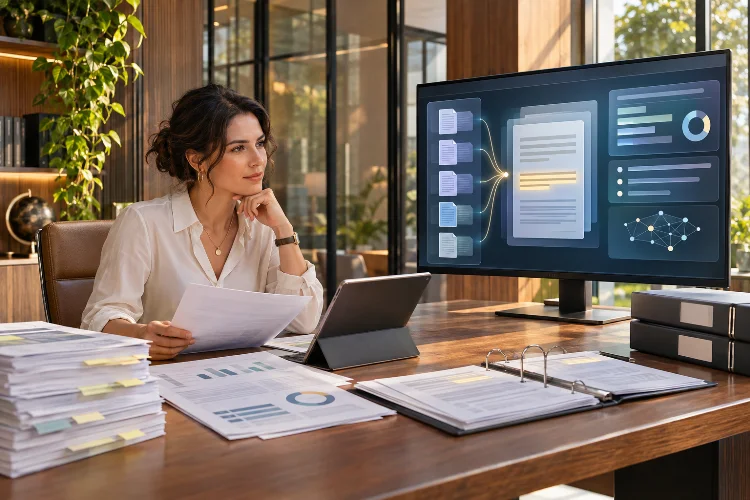
Pernah membayangkan harus membaca ratusan halaman laporan keuangan, kontrak bisnis, atau dokumen penelitian hanya untuk menemukan beberapa informasi penting?
Pekerjaan seperti ini tentu menghabiskan banyak waktu, apalagi ketika informasi yang dicari tersebar di berbagai file dengan format berbeda.
ChatGPT memang bisa membantu memahami dan merangkum dokumen. Namun, ketika jumlah file semakin banyak dan pembahasannya semakin kompleks, mengandalkan kemampuan model bahasa saja belum tentu cukup untuk menghasilkan jawaban yang akurat.
Di sinilah optimasi ChatGPT untuk analisis dokumen kompleks berbasis RAG menjadi solusi yang menarik. Teknologi Retrieval-Augmented Generation (RAG) memungkinkan kecerdasan buatan mengambil informasi relevan dari sumber tertentu sebelum menyusun jawaban.
Dengan pendekatan tersebut, analisis tidak hanya mengandalkan pengetahuan bawaan AI, tetapi juga menggunakan data yang benar-benar tersedia dalam dokumen.
Menariknya, penerapan RAG tidak selalu membutuhkan sistem yang rumit. Dengan memahami pengolahan dokumen, pencarian semantik, dan penyusunan prompt yang tepat, pengguna bisa membangun proses analisis yang lebih efisien.
Lalu, bagaimana cara mengoptimalkannya agar hasil analisis tetap relevan, mudah diperiksa, dan bermanfaat untuk kebutuhan profesional?
1. Memahami Cara Kerja ChatGPT dan Teknologi RAG
Sebelum membahas strategi optimasi, penting untuk memahami hubungan antara ChatGPT dan Retrieval-Augmented Generation.
Secara sederhana, RAG merupakan metode yang menggabungkan kemampuan model bahasa dengan sistem pencarian informasi eksternal. Ketika pengguna mengajukan pertanyaan, sistem terlebih dahulu mencari bagian dokumen yang paling berkaitan dengan pertanyaan tersebut.
Informasi yang ditemukan kemudian diberikan kepada model sebagai konteks tambahan untuk menghasilkan jawaban.
Perbedaan Analisis Biasa dan Analisis Berbasis RAG
Dalam penggunaan biasa, pengguna dapat mengunggah dokumen ke ChatGPT untuk meminta ringkasan atau penjelasan. Namun, mengunggah file tidak otomatis berarti pengguna sudah membangun pipeline RAG dengan indeks pencarian khusus.
Pada implementasi RAG, dokumen umumnya diproses menjadi bagian-bagian kecil yang dapat dicari melalui sistem retrieval.
Sebagai contoh, sebuah perusahaan memiliki 150 laporan operasional dari beberapa tahun terakhir. Ketika manajer menanyakan perubahan biaya distribusi, sistem dapat mencari bagian laporan yang relevan tanpa harus memasukkan seluruh isi dokumen sekaligus.
Pendekatan ini membantu mengurangi informasi yang tidak diperlukan sekaligus meningkatkan peluang ditemukannya konteks yang tepat.
2. Menyiapkan Dokumen agar Mudah Dianalisis AI
Kualitas analisis sangat dipengaruhi oleh kualitas data yang digunakan. Dokumen yang tidak terstruktur, memiliki halaman duplikat, atau mengandung teks hasil pemindaian yang buruk dapat menyebabkan informasi penting sulit ditemukan.
Karena itu, proses persiapan dokumen menjadi langkah awal yang tidak boleh diabaikan.
Membersihkan dan Mengelompokkan Data
Mulailah dengan memisahkan dokumen berdasarkan kategori, seperti laporan keuangan, kebijakan perusahaan, kontrak, atau hasil penelitian.
Untuk file PDF berbasis gambar, teknologi Optical Character Recognition (OCR) mungkin diperlukan agar teks dapat dibaca sistem. Hasil ekstraksi tetap perlu diperiksa, terutama pada angka, tabel, dan istilah teknis.
Selanjutnya, simpan metadata berupa judul, tanggal, kategori, versi, serta sumber dokumen. Informasi ini membantu sistem membedakan laporan lama dengan laporan terbaru.
Misalnya, ketika tersedia beberapa versi kontrak kerja sama, metadata memungkinkan pencarian difokuskan pada versi yang berlaku.
Persiapan yang rapi membuat proses pencarian lebih terstrukur dan mempermudah pemeriksaan hasil analisis.
3. Mengoptimalkan Chunking dan Vector Database
Salah satu bagian penting dalam arsitektur RAG adalah chunking, yaitu teknik membagi dokumen panjang menjadi potongan teks yang lebih kecil.
Tujuannya bukan sekadar memperpendek dokumen, melainkan memastikan setiap bagian memiliki konteks yang cukup untuk ditemukan saat pencarian berlangsung.
Jika potongan terlalu pendek, informasi bisa kehilangan makna. Sebaliknya, potongan yang terlalu panjang dapat membawa banyak informasi tambahan yang tidak berhubungan dengan pertanyaan.
Menentukan Ukuran Chunk yang Tepat
Tidak ada ukuran chunk yang selalu ideal untuk semua dokumen. Laporan teknis, dokumen hukum, dan artikel ilmiah memiliki struktur informasi yang berbeda.
Sebagai gambaran, dokumentasi Retrieval OpenAI menjelaskan konfigurasi bawaan sebesar 800 token per chunk dengan overlap 400 token. Pengaturan tersebut dapat disesuaikan berdasarkan kebutuhan aplikasi.
Overlap memungkinkan sebagian teks muncul pada dua potongan berdekatan sehingga konteks antarbagiannya tidak langsung terputus.
Setelah proses chunking, teks dapat diubah menjadi embedding, yaitu representasi numerik yang menggambarkan hubungan makna antarbagian teks.
Embedding kemudian disimpan dalam vector database atau indeks pencarian. Teknologi ini memungkinkan sistem menemukan informasi berdasarkan kemiripan makna, bukan hanya kecocokan kata secara persis.
4. Meningkatkan Relevansi dengan Hybrid Search dan Reranking
Pencarian semantik merupakan komponen penting dalam analisis dokumen berbasis AI. Namun, menggunakan pencarian vektor saja belum tentu menghasilkan informasi paling relevan untuk setiap pertanyaan.
Misalnya, pengguna ingin menemukan klausul kontrak dengan kode tertentu. Dalam situasi ini, pencarian berdasarkan kata kunci mungkin lebih efektif dibandingkan pencarian berdasarkan kemiripan makna.
Karena itulah metode hybrid search semakin menarik untuk digunakan.
Hybrid search menggabungkan pencarian keyword dan pencarian vektor dalam satu proses. Hasil keduanya kemudian digabungkan untuk mendapatkan kandidat informasi yang lebih sesuai.
Mengapa Reranking Penting?
Setelah sistem menemukan sejumlah potongan dokumen, teknik reranking dapat digunakan untuk mengurutkan kembali hasil berdasarkan relevansi terhadap pertanyaan.
Bayangkan sistem menemukan 20 potongan dokumen yang berkaitan dengan kebijakan pengeluaran perusahaan. Tidak semua potongan tersebut tentu menjelaskan aturan yang benar-benar dibutuhkan.
Dengan reranking, bagian yang paling sesuai dapat diprioritaskan sebelum diberikan kepada ChatGPT.
Pendekatan ini membantu meningkatkan kualitas konteks sekaligus mengurangi beban pemrosesan informasi yang kurang relevan.
Namun, hasil tetap perlu diuji karena skor relevnasi yang tinggi tidak selalu menjamin kebenaran jawaban akhir.
5. Merancang Prompt ChatGPT yang Lebih Akurat
Selain teknologi pencarian, cara memberikan instruksi kepada ChatGPT juga berpengaruh besar terhadap kualitas analisis.
Prompt yang terlalu umum sering menghasilkan jawaban luas, sementara instruksi yang spesifik membantu model memahami informasi apa yang sebenarnya dibutuhkan.
Contohnya, daripada meminta AI untuk sekadar merangkum laporan, pengguna dapat menentukan periode, indikator, sumber, dan format jawaban.
Contoh Prompt untuk Analisis Dokumen
Analisis perubahan biaya operasional perusahaan berdasarkan dokumen yang tersedia. Bandingkan periode 2024 dan 2025, jelaskan faktor penyebab perubahan, serta sertakan nama dokumen dan halaman sumber. Pisahkan fakta dari interpretasi. Jika informasi tidak tersedia, nyatakan secara jelas tanpa membuat asumsi.
Prompt tersebut memberikan batasan yang lebih spesifik sehingga hasil analisis lebih mudah diverifikasi.
Untuk kebutuhan yang lebih kompleks, pengguna juga dapat meminta ChatGPT menyusun tabel perbandingan, mengidentifikasi perbedaan antarversi dokumen, atau menjelaskan hubungan antara beberapa temuan.
Hal penting lainnya adalah meminta model membedakan informasi faktual dengan kesimpulan interpretatif.
Dengan demikian, pembaca dapat mengetahui bagian mana yang berasal langsung dari dokumen dan bagian mana yang merupakan hasil analisis AI.
6. Mengukur Akurasi, Keamanan, dan Efisiensi Sistem RAG
Membangun sistem RAG tidak cukup hanya dengan membuatnya mampu menjawab pertanyaan. Kualitas jawaban juga harus dievaluasi secara konsiten agar sistem dapat digunakan dalam pekerjaan yang membutuhkan ketelitian.
Salah satu metode evaluasi adalah menyiapkan kumpulan pertanyaan beserta jawaban acuan dari dokumen yang sudah diperiksa.
Kemudian, bandingkan hasil sistem berdasarkan ketepatan informasi, relevansi sumber, kelengkapan jawaban, dan kemampuan memberikan rujukan yang benar.
Menghindari Halusinasi dan Kebocoran Data
Meskipun RAG dapat membantu mengurangi jawaban tanpa dasar yang jelas, teknologi ini tidak sepenuhnya menghilangkan risiko halusinasi.
Model masih mungkin salah menafsirkan tabel, mengambil konteks yang keliru, atau menyimpulkan sesuatu yang tidak didukung sumber.
Risiko lainnya adalah prompt injection, yaitu ketika dokumen yang diproses mengandung instruksi berbahaya yang berusaha memengaruhi perilaku AI.
Karena itu, sistem perlu membatasi akses berdasarkan hak pengguna, memisahkan isi dokumen dari instruksi utama, serta menerapkan pemeriksaan keamanan.
Untuk dokumen sensitif, seperti kontrak rahasia atau informasi pelanggan, perhatikan juga kebijakan penyimpanan dan pengolahan data dari layanan yang digunakan.
Terakhir, evaluasi waktu respons dan biaya pemrosesan. Sistem yang akruat tetapi terlalu lambat atau mahal belum tentu cocok untuk kebutuhan operasional sehari-hari.
Optimasi terbaik adalah menemukan keseimbangan antara kualitas jawaban, keamanan, kecepatan, dan biaya.
Optimasi ChatGPT untuk analisis dokumen kompleks berbasis RAG menawarkan pendekatan yang lebih terarah untuk mengolah informasi dalam jumlah besar.
Dengan menggabungkan kemampuan model bahasa dan pencarian dokumen, pengguna dapat memperoleh jawaban yang lebih relevan serta memiliki sumber yang dapat diperiksa.
Keberhasilan implementasinya bergantung pada beberapa komponen penting, mulai dari persiapan data, pengaturan chunking, penggunaan vector database, hingga strategi hybrid search dan prompt engineering.
Selain itu, evaluasi akurasi serta perlindungan informasi sensitif harus menjadi bagian dari proses pengembangan.
Bagi perusahaan, peneliti, maupun profesional yang sering bekerja dengan dokumen panjang, teknologi ini membuka peluang untuk menghemat waktu tanpa mengabaikan ketelitian.
Mulailah dengan menguji RAG menggunakan sejumlah dokumen yang sudah dikenal, evaluasi hasilnya, lalu tingkatkan sistem secara bertahap. Dengan strategi yang tepat, ChatGPT dapat menjadi alat pendukung analisis yang jauh lebih bermanfaat.