
Pernah mencoba memasukkan dokumen ratusan halaman ke ChatGPT, lalu mendapatkan ringkasan yang justru melewatkan informasi penting?
Atau mungkin AI tiba-tiba lupa instruksi awal ketika percakapan semakin panjang? Situasi seperti ini cukup sering terjadi saat menggunakan kecerdasan buatan untuk mengolah data dalam jumlah besar.
Salah satu penyebabnya berkaitan dengan context window, yaitu kapasitas informasi yang bisa diproses model AI dalam satu konteks.
Meskipun teknologi AI terus berkembang dan kapasitasnya semakin besar, kemampuan memahami seluruh informasi secara konsisten tetap memiliki keterbatasan.
Karena itu, memahami strategi mengelola context window AI menjadi penting, terutama untuk pekerjaan yang melibatkan laporan tahunan, dokumen hukum, penelitian akademik, atau arsip perusahaan.
Menariknya, solusi masalah ini bukan sekadar memilih model dengan kapasitas token paling besar. Kamu juga perlu memahami cara membagi dokumen, menyusun ringkasan, dan mengambil informasi yang benar-benar relevan.
Dalam artikel ini, kita akan membahas berbagai teknik pengelolaan konteks AI, mulai dari chunking, hierarchical summarization, hingga Retrieval-Augmented Generation (RAG).
Semua dijelaskan dengan pendekatan praktis supaya mudah diterapkan, bahkan jika kamu belum terlalu familiar dengan istilah teknis AI.
1. Pahami Cara Kerja Context Window dan Token AI
Sebelum membahas strategi pengelolaan dokumen, kamu perlu memahami konsep dasarnya. Context window bisa diibaratkan sebagai ruang kerja sementara yang digunakan model bahasa untuk membaca instruksi, riwayat percakapan, dan materi referensi.
Informasi tersebut diproses dalam satuan bernama token. Satu token tidak selalu sama dengan satu kata karena jumlahnya dipengaruhi bahasa, tanda baca, dan metode tokenisasi.
Mengapa Kapasitas Besar Belum Tentu Lebih Akurat?
Beberapa model AI modern mampu menangani ratusan ribu hingga lebih dari satu juta token. Namun, kapasitas maksimal tidak otomatis menjamin setiap detail dalam dokumen akan dipahami dengan kualitas yang sama.
Penelitian berjudul Lost in the Middle: How Language Models Use Long Contexts menemukan bahwa sejumlah model yang diuji mengalami penurunan performa ketika informasi penting berada di tengah konteks panjang.
Artinya, memasukkan seluruh dokumen sekaligus bukan selalu pendekatan terbaik. Kamu tetap membutuhkan strategi untuk memastikan bagian paling relevan mendapatkan perhatian yang cukup.
2. Seleksi Informasi Sebelum Memasukkan Dokumen ke AI
Kesalahan yang sering dilakukan pengguna adalah mengunggah semua dokumen tanpa menentukan tujuan analisisnya. Padahal, semakin banyak informasi yang tidak relevan, semakin sulit model memusatkan respons pada hal yang benar-benar dibutuhkan.
Misalnya, kamu memiliki laporan perusahaan sepanjang 300 halaman dan hanya ingin mengetahui perkembangan pendapatan tahunan.
Daripada meminta AI membaca semuanya tanpa arahan, identifikasi terlebih dahulu bagian laporan keuangan, pembahasan manajemen, serta catatan yang berkaitan dengan pendapatan.
Gunakan Prinsip Relevansi Informasi
Mulailah dengan menentukan pertanyaan utama, lalu pilih dokumen atau bagian yang dapat menjawabnya. Singkirkan halaman duplikat, lampiran tidak relevan, dan teks hasil ekstraksi PDF yang berantakan.
Proses kurasi ini membantu menghemat token sekaligus mengurangi gangguan konteks. Hasilnya, AI memiliki ruang lebih besar untuk memproses infromasi penting dan menyusun jawaban yang lebih fokus.
3. Terapkan Teknik Chunking untuk Membagi Dokumen Besar
Chunking merupakan teknik membagi dokumen panjang menjadi potongan teks yang lebih kecil. Setiap potongan kemudian dapat dianalisis secara terpisah atau digunakan dalam sistem pencarian informasi berbasis AI.
Microsoft menjelaskan bahwa pembagian dokumen membantu memenuhi batas input model sekaligus meningkatkan efektivitas sistem Retrieval-Augmented Generation.
Menentukan Ukuran Chunk yang Ideal
Tidak ada ukuran potongan yang cocok untuk semua dokumen. Namun, panduan Azure AI Search menyarankan titik awal sekitar 512 token dengan tumpang tindih 25% untuk beberapa kebutuhan pencarian berbasis vektor.
Teknik tumpang tindih atau overlap berguna agar kalimat yang saling berkaitan tidak kehilangan konteks ketika dipisahkan. Bayangkan sebuah penjelasan dimulai pada akhir halaman pertama dan kesimpulannya muncul pada halaman berikutnya.
Untuk dokumen terstrukur, sebaiknya pembagian mengikuti bab, subbab, atau paragraf. Dengan begitu, setiap bagian tetap memiliki makna yang utuh meskipun diproses secara terpisah.
4. Gunakan Hierarchical Summarization agar Informasi Tetap Utuh
Ketika dokumen terlalu panjang, membuat satu ringkasan langsung sering menghasilkan pembahasan yang terlalu umum. Solusi alternatifnya adalah hierarchical summarization, yaitu metode meringkas informasi secara bertingkat.
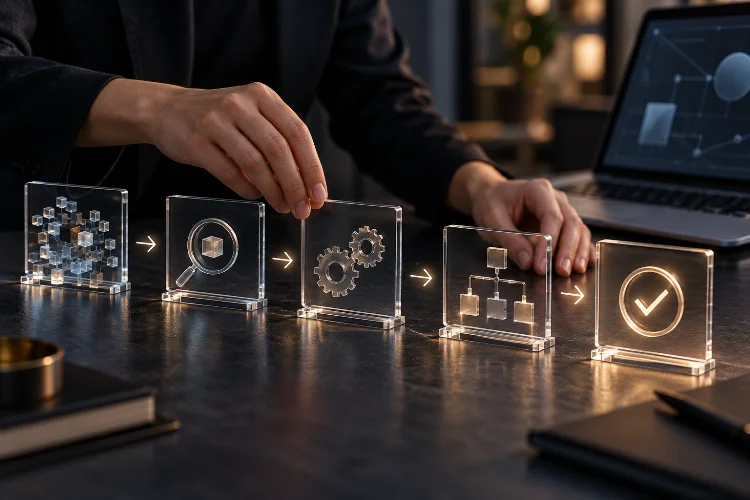
Prosesnya dimulai dengan merangkum setiap bagian dokumen secara terpisah. Selanjutnya, ringkasan tersebut digabungkan untuk menghasilkan kesimpulan pada tingkat yang lebih tinggi.
Contoh Penerapan Ringkasan Bertingkat
Bayangkan kamu memiliki laporan penelitian sepanjang 200 halaman. Langkah pertama adalah membuat ringkasan setiap bab yang mencakup temuan, angka penting, metode, dan keterbatasan penelitian.
Setelah seluruh bab selesai, mintalah AI menyusun ringkasan eksekutif berdasarkan hasil sebelumnya. Pendekatan ini membantu mempertahankan informasi utama tanpa harus memasukkan seluruh teks berulang kali.
Namun, ringkasan tetap berpotensi menghilangkan detail. Karena itu, simpan tautan atau nomor halaman sumber asli agar klaim penting bisa diperiksa kembali.
5. Manfaatkan Retrieval-Augmented Generation (RAG)
Jika kamu sering mengakses ratusan atau ribuan dokumen, memproses semuanya secara manual tentu kurang efesien. Di sinilah Retrieval-Augmented Generation atau RAG menjadi solusi yang menarik.
RAG merupakan pendekatan yang menggabungkan kemampuan model bahasa dengan sistem pencarian informasi. Alih-alih memasukkan seluruh koleksi dokumen, sistem mengambil bagian yang paling relevan dengan pertanyaan pengguna.
Misalnya, perusahaan memiliki ribuan dokumen kebijakan internal. Ketika karyawan menanyakan aturan cuti, sistem RAG dapat mencari bagian dokumen terkait dan menggunakannya sebagai konteks jawaban.
Keunggulannya terletak pada efisiensi penggunaan token dan kemudahan menghubungkan respons dengan sumber. Meski demikian, kualitas jawaban tetap bergantung pada ketepatan pencarian, kelengkapan dokumen, dan kemampuan model memahami potongan yang ditemukan.
6. Optimalkan Struktur Prompt untuk Konteks Panjang
Pengelolaan konteks tidak hanya berkaitan dengan ukuran dokumen, tetapi juga cara menyusun instruksi. Prompt yang terlalu umum dapat membuat AI menghasilkan jawaban melebar, terutama ketika menerima banyak referensi sekaligus.
Panduan Anthropic dan Google menyarankan pengaturan konteks panjang secara jelas, termasuk pemisahan dokumen berdasarkan sumber serta penempatan pertanyaan spesifik setelah materi referensi.
Contoh Prompt untuk Analisis Dokumen
“Analisis dokumen laporan tahunan yang diberikan. Fokus pada perubahan pendapatan, biaya operasional, dan risiko bisnis.
Gunakan hanya informasi dari dokumen, sertakan nomor halaman untuk setiap angka penting, dan tandai data yang tidak ditemukan. Sajikan hasil dalam lima paragraf dengan kesimpulan singkat.”
Instruksi tersebut membantu AI memahami prioritas analisis sekaligus membatasi informasi yang boleh digunakan.
Jika melibatkan banyak dokumen, tambahkan identitas seperti nama berkas, tahun penerbitan, dan nomor halaman. Metadata ini mempermudah penelusuran sumber serta menjaga hasil analisis tetap konsiten.
7. Lakukan Evaluasi Konteks dan Kelola Riwayat Percakapan
Strategi terakhir adalah melakukan evaluasi secara berkala. Jangan menganggap analisis berhasil hanya karena AI mampu memberikan jawaban panjang dan terlihat meyakinkan.
Cobalah menguji model dengan pertanyaan yang jawabannya berada pada bagian awal, tengah, dan akhir dokumen. Jika hasilnya berbeda-beda, kamu mungkin perlu memperbaiki ukuran chunk, metode pengambilan informasi, atau susunan prompt.
Untuk percakapan yang berlangsung lama, gunakan ringkasan berkala yang mencatat tujuan, keputusan, asumsi, dan temuan penting.
Pendekatan ini berkaitan dengan konsep context compaction, yaitu pengurangan ukuran konteks sambil mempertahankan informasi yang diperlukan untuk melanjutkan pekerjaan.
Jangan lupa menyediakan ruang token untuk jawaban AI, bukan hanya materi input. Pada beberapa arsitektur model, anggaran konteks juga perlu memperhitungkan proses penalaran dan keluaran.
Terakhir, dokumentasikan strategi yang paling berhasil. Dengan evaluasi teratur, kamu bisa membangun alur kerja pengolahan dokumen yang lebih stabil, akurat, dan mudah digunakan kembali.
Mengolah dokumen berskala besar menggunakan AI membutuhkan pendekatan yang lebih cermat daripada sekadar mengunggah berkas dan meminta ringkasan.
Kapasitas context window memang terus berkembang, tetapi tantangan seperti keterbatasan token, hilangnya detail, dan penurunan relevansi tetap perlu diperhatikan.
Melalui teknik chunking, ringkasan bertingkat, RAG, serta optimasi prompt, kamu bisa membantu AI memproses informasi secara lebih terarah. Evaluasi berkala dan pengelolaan riwayat percakapan juga penting untuk menjaga kualitas hasil dalam pekerjaan jangka panjang.
Tidak semua strategi harus digunakan sekaligus. Untuk dokumen sederhana, pembagian berdasarkan bab mungkin sudah cukup, sedangkan koleksi dokumen besar bisa membutuhkan sistem pencarian khusus.
Sekarang saatnya mencoba! Ambil satu dokumen panjang yang biasa kamu analisis, pecah menjadi beberapa bagian, lalu bandingkan hasilnya dengan metode unggah sekaligus. Dari eksperimen sederhana tersebut, kamu bisa menemukan pendekatan yang paling sesuai dengan kebutuhanmu.