
Pernah menerima jawaban ChatGPT yang terlihat sangat meyakinkan, tetapi setelah diperiksa ternyata ada informasi yang keliru? Masalahnya, AI bisa menghasilkan penjelasan yang terdengar logis meskipun sebagian fakta, angka, atau kesimpulannya tidak benar.
Situasi ini cukup berisiko, terutama ketika AI digunakan untuk menyusun laporan bisnis, menganalisis penelitian, membuat artikel, atau membantu mengambil keputusan penting. Satu kesalahan kecil bahkan bisa memengaruhi keseluruhan hasil analisis jika tidak terdeteksi sejak awal.
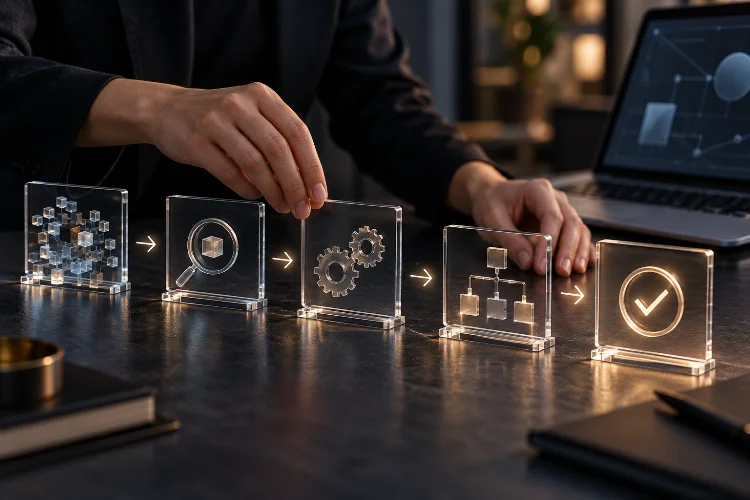
Di sinilah teknik penalaran bertahap menjadi pendekatan yang menarik. Metode ini membantu pengguna memeriksa output AI melalui serangkaian tahapan yang terstruktur, bukan hanya menilai apakah jawabannya terdengar masuk akal.
Dengan proses audit yang sistimatis, kamu bisa mengevaluasi fakta, memeriksa hubungan antarargumen, dan memastikan kesimpulan didukung bukti yang memadai.
Menariknya, pendekatan ini tidak mengharuskan kamu memahami pemrograman atau algoritma kecerdasan buatan secara mendalam. Cukup menguasai beberapa langkah pemeriksaan sederhana yang dapat diterapkan berulang kali.
Artikel ini akan membahas cara melakukan audit jawaban AI, mulai dari mengidentifikasi klaim hingga menyusun evaluasi akhir. Tujuannya agar kamu bisa menggunakan teknologi AI secara lebih kritis, efektif, dan bertanggung jawab.
1. Memahami Penalaran Bertahap dalam Evaluasi AI
Penalaran bertahap merupakan pendekatan untuk menyelesaikan atau memeriksa persoalan melalui beberapa tahapan yang saling berkaitan. Dalam audit AI, metode ini digunakan untuk mengevaluasi informasi secara terstruktur sebelum hasilnya dianggap layak digunakan.
Berbeda dengan pemeriksaan sekilas, pendekatan ini memisahkan penilaian fakta, logika, relevansi, dan kesimpulan. Setiap aspek diperiksa berdasarkan kriteria yang jelas sehingga kesalahan lebih mudah ditemukan.
Mengapa Audit Bertahap Diperlukan?
AI generatif dapat menghasilkan informasi yang tidak akurat atau tidak didukung bukti, sebuah fenomena yang dikenal sebagai hallucination. NIST mengidentifikasi masalah ini sebagai salah satu risiko penting dalam penggunaan sistem AI generatif.
Karena itu, jawaban yang terliat profesional belum tentu benar. Audit bertahap membantu memastikan kualitas informasi tidak hanya dinilai dari kelancaran bahasa, tetapi juga berdasarkan bukti yang dapat diperiksa.
Penting dipahami bahwa metode ini berfokus pada pemeriksaan jawaban dan bukti yang tersedia, bukan menganggap proses penalaran internal model selalu dapat diketahui.
2. Pecah Output AI Menjadi Klaim yang Bisa Diperiksa
Langkah pertama dalam evaluasi adalah memecah jawaban AI menjadi beberapa klaim utama. Cara ini membuat proses pemeriksaan lebih mudah dibandingkan langsung mengevaluasi seluruh paragraf sekaligus.
Misalnya, ChatGPT menyatakan bahwa penggunaan AI meningkatkan produktivitas bisnis sebesar 40% dan mengurangi biaya operasional. Pernyataan tersebut sebenarnya mengandung dua klaim berbeda yang masing-masing membutuhkan bukti.
Kamu perlu memeriksa dari mana angka 40% berasal, bagaimana produktivitas diukur, serta apakah pengurangan biaya benar-benar terjadi pada konteks bisnis yang sama.
Prioritaskan Klaim Berisiko Tinggi
Tidak semua informasi membutuhkan tingkat pemeriksaan identik. Angka statistik, kutipan penelitian, regulasi, dan rekomendasi finansial biasanya memerlukan perhatian lebih besar daripada penjelasan umum.
Dengan menetapkan prioritas, audit menjadi lebih efisien. Kamu bisa mengalokasikan waktu untuk informasi yang berpotensi menimbulkan dampak paling serius jika ternyata salah.
3. Terapkan Chain-of-Verification untuk Menguji Fakta
Salah satu pendekatan yang relevan adalah Chain-of-Verification (CoVe), yang diperkenalkan dalam penelitian Dhuliawala dan rekan-rekannya pada 2023.
Penelitian tersebut menunjukkan bahwa proses verifikasi terstruktur dapat mengurangi halusinasi model bahasa pada berbagai tugas pengujian.
Metodenya dimulai dengan membuat jawaban awal, menyusun pertanyaan pemeriksaan, menjawab pertanyaan verifikasi secara terpisah, kemudian memperbaiki respons berdasarkan hasilnya.
Contoh Penerapan Chain-of-Verification
Bayangkan AI menyebut sebuah perusahaan mengalami pertumbuhan pendapatan sebesar 25% pada 2025. Jangan langsung menggunakan informasi tersebut dalam laporan.
Ajukan pertanyaan lanjutan mengenai sumber laporan, periode perbandingan, nilai pendapatan awal, dan metode perhitungan pertumbuhannya. Setelah itu, cocokkan hasilnya dengan dokumen keuangan resmi.
Pemeriksaan sebaiknya dilakukan menggunakan bukti independen, bukan hanya meminta AI mengonfirmasi jawabannya sendiri. Dengan begitu, kesalahan awal tidak otomatis terbawa ke proses verfikasi berikutnya.
4. Evaluasi Konsistensi Logika dan Hubungan Antarargumen
Output AI bisa saja menggunakan fakta yang benar, tetapi menghasilkan kesimpulan yang tidak tepat. Hal ini terjadi ketika hubungan antara bukti dan argumen tidak diperiksa secara menyeluruh.
Misalnya, AI menyimpulkan bahwa peningkatan penjualan disebabkan oleh penggunaan chatbot. Padahal, laporan perusahaan juga menunjukkan adanya promosi besar-besaran pada periode yang sama.
Dalam situasi tersebut, peningkatan penjualan belum cukup untuk membuktikan hubungan sebab-akibat. Bisa saja terdapat faktor lain yang turut memengaruhi hasil bisnis.
Untuk memeriksanya, tanyakan apakah kesimpulan benar-benar mengikuti bukti, apakah terdapat asumsi tersembunyi, dan apakah penjelasan alternatif sudah dipertimbangkan.
Microsoft memasukkan coherence atau konsistensi logis sebagai salah satu dimensi evaluasi kualitas respons AI. Prinsip ini membantu membedakan jawaban yang sekadar terdengar masuk akal dengan argumen yang tersusun kuat.
5. Gunakan Rubrik Penilaian agar Audit Lebih Objektif
Mengandalkan intuisi saja membuat hasil evaluasi mudah berubah. Karena itu, kamu memerlukan rubrik penilaian yang mengukur kualitas output berdasarkan kriteria tertentu.
OpenAI melalui panduan Evaluation Best Practices merekomendasikan evaluasi berbasis tujuan, dataset pengujian, dan metrik yang sesuai dengan kebutuhan penggunaan AI.
Contoh Rubrik Audit Output AI
Sebagai contoh praktis, gunakan skala 1–5 untuk menilai empat aspek berikut:
| Aspek Audit | Fokus Pemeriksaan |
|---|---|
| Akurasi | Kesesuaian fakta dengan sumber |
| Relevansi | Ketepatan jawaban terhadap pertanyaan |
| Logika | Konsistensi argumen dan kesimpulan |
| Kelengkapan | Cakupan informasi penting |
Skor 1 menunjukkan kualitas buruk, sedangkan skor 5 menunjukkan hasil sangat baik. Rubrik ini merupakan contoh penilaian internal, bukan standar resmi universal.
Selain memberikan skor, tambahkan catatan singkat mengenai kesalahan yang ditemukan. Hasilnya akan lebih berguna untuk revisi dan membantu menjaga penilaian tetap konsiten ketika banyak output diperiksa.
6. Manfaatkan AI sebagai Pemeriksa Tambahan
Menariknya, AI juga dapat membantu mengevaluasi hasil AI lainnya. Pendekatan ini dikenal sebagai LLM-as-a-Judge, yaitu penggunaan model bahasa untuk menilai respons berdasarkan kriteria tertentu.
Teknik tersebut berguna untuk pemeriksaan format, relevansi, kelengkapan, dan kesesuaian jawaban dengan dokumen referensi. Namun, penilaian otomatis tetap dapat mengandung bias atau kesalahan.
Contoh Prompt Audit AI
“Evaluasi jawaban AI berikut berdasarkan akurasi fakta, relevansi, konsistensi logika, dan kelengkapan. Pisahkan setiap klaim penting, identifikasi bagian yang tidak didukung sumber, dan berikan skor 1–5 untuk setiap aspek.
Jelaskan temuan secara singkat serta sarankan perbaikan. Jangan menganggap klaim benar tanpa bukti.”
Prompt tersebut membantu menghasilkan laporan evaluasi yang lebih terstruktur. Untuk hasil maksimal, lampirkan sumber asli atau dokumen pembanding agar pemeriksaan tidak hanya mengandalkan pengetahuan model.
Tetap lakukan pemeriksaan manusia pada informasi penting, terutama yang berkaitan dengan kesehatan, hukum, atau keputusan keuangan.
7. Dokumentasikan Temuan dan Lakukan Pengujian Ulang
Audit tidak berhenti ketika kesalahan berhasil ditemukan. Kamu juga perlu mencatat penyebab masalah dan memastikan perbaikan benar-benar meningkatkan kualitas respons.
Buat catatan sederhana berisi pertanyaan awal, jawaban AI, klaim bermasalah, sumber pembanding, dan hasil revisi. Dokumentasi ini berguna ketika kamu mengerjakan tugas serupa secara berulang.
Selanjutnya, uji prompt menggunakan beberapa kasus berbeda. Misalnya, gunakan pertanyaan sederhana, kasus dengan data tidak lengkap, dan pertanyaan yang memiliki informasi saling bertentangan.
Bandingkan hasil sebelum dan sesudah perbaikan untuk melihat apakah tingkat kesalahan berkurang. Pendekatan ini sejalan dengan prinsip evaluasi berkelanjutan yang digunakan dalam pengembangan aplikasi AI.
Dengan dokumentasi dan pengujian rutin, proses audit akan semakin terarah serta mudah diterapkan dalam pekerjaan sehari-hari.
Teknik penalaran bertahap membantu pengguna mengevaluasi output AI secara lebih kritis dan terstruktur.
Daripada langsung mempercayai jawaban yang terdengar meyakinkan, kamu dapat memeriksa setiap klaim, mengevaluasi bukti, menguji hubungan logis, dan menilai kualitas respons menggunakan rubrik yang jelas.
Pendekatan seperti Chain-of-Verification, pemeriksaan sumber independen, dan LLM-as-a-Judge dapat membantu menemukan kesalahan yang sebelumnya terlewat.
Namun, teknologi tersebut tetap membutuhkan pengawasan manusia, terutama ketika hasil analisis digunakan untuk keputusan penting.
Kunci utamanya bukan membuat setiap jawaban AI sempurna, melainkan membangun proses pemeriksaan yang konsisten, transparan, dan bisa diulang.
Sekarang giliran kamu mencobanya! Ambil satu jawaban ChatGPT yang pernah digunakan, pecah menjadi beberapa klaim, lalu periksa bukti serta kesimpulannya. Dari langkah sederhana tersebut, kamu bisa mulai membangun kebiasaan audit AI yang lebih efektif dan dapat dipercaya.